

设置您的环境
-
设置您的 Python 环境。在主机上安装
miniconda。
为 AI Hub 设置 Python 虚拟环境:
-
安装 git。
-
安装 AI Hub Python 客户端。
- 登录 AI Hub。 访问 AI Hub,使用您的 Qualcomm ID 登录,以查看您创建的作业信息。 登录后,前往 Account > Settings > API Token 获取用于配置客户端的 API token。
-
在终端中使用以下命令,
通过您的 API token 配置客户端。
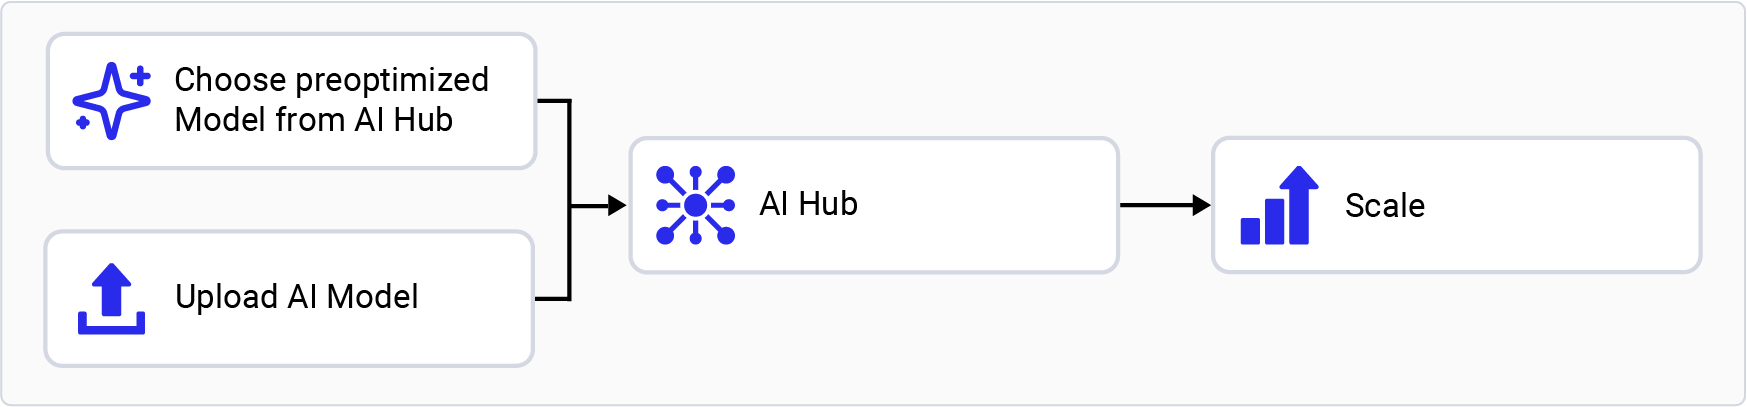
选择 AI Hub 工作流
试用预优化模型
- 前往 AI Hub Model Zoo,获取适用于 Qualcomm 评估套件的预优化模型。
- 在左侧窗格中选择匹配的芯片组,筛选适用于您 EVK 的模型。例如, 为 Qualcomm Dragonwing™ RB3 Gen 2 选择 Qualcomm QCS6490,或为 Qualcomm Dragonwing™ IQ-8275 EVK 选择 Qualcomm QCS8300。
- 从筛选结果中选择一个模型,进入该模型页面。
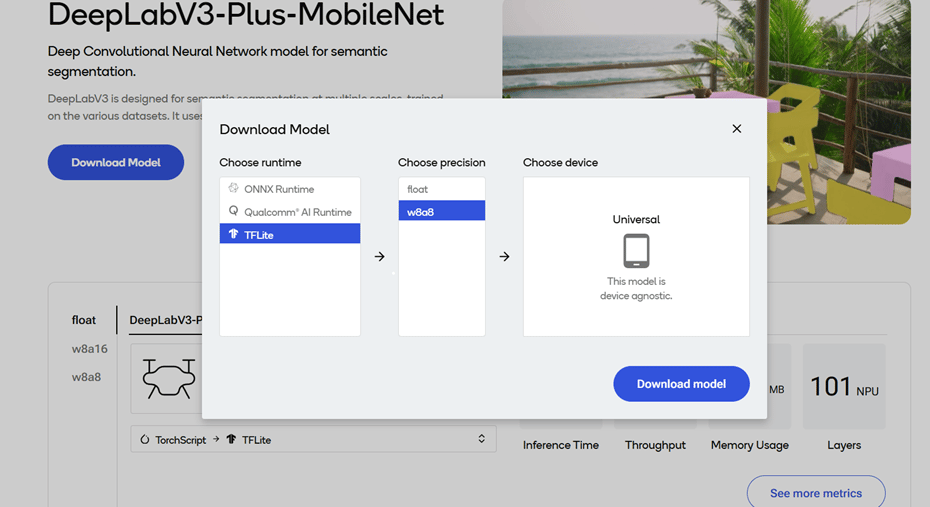
- 在模型页面上,选择运行时和精度。
- 选择 Download 下载模型。下载的模型已经过预优化,可以直接部署。有关更多信息,请参阅运行推理。
自带模型
- 选择 PyTorch 或 ONNX 格式的预训练模型。
-
使用 Python API 向 AI Hub 提交模型进行编译或优化。
提交编译作业时,为您的 EVK 选择设备或芯片组以及目标运行时。对于 Qualcomm Dragonwing™ RB3 Gen 2,支持 LiteRT 运行时。
提交后,AI Hub 会为该作业生成唯一 ID。您可以使用 此作业 ID 查看作业详情。
-
AI Hub 根据您选择的设备和运行时优化模型。
-
您还可以选择提交一个作业,在从设备农场调配的真实设备上
对优化后的模型进行性能分析或运行推理
(使用 Python API)。
- 性能分析: 在调配的设备上对模型进行基准测试,并 提供统计信息,包括层级别的平均推理时间、 运行时配置等。
- 推理: 在调配的设备上运行模型,使用优化后的模型 对作为推理作业一部分提交的数据 执行推理。
-
您还可以选择提交一个作业,在从设备农场调配的真实设备上
对优化后的模型进行性能分析或运行推理
(使用 Python API)。
- 每个提交的作业都可以在 AI Hub 门户中查看。完成的编译作业会提供优化后模型的下载链接,随后可将其部署到本地开发设备,例如 Qualcomm Dragonwing™ RB3 Gen 2。
要停用先前激活的
qai_hub 环境,请使用以下命令。