

label_image 示例应用程序、LiteRT C++ API 或 Qualcomm IM SDK 的 gst-ai-classification 管道,在 Qualcomm 开发套件上运行 LiteRT 模型。
部署之前,请确保您已完成前提条件和模型设置。
作为原生应用程序部署
label_image 示例应用程序是 TensorFlow 仓库的一部分,与 LiteRT 库交叉编译并安装在目标设备上。它加载一个分类 LiteRT 模型,并使用委托(delegate)对图像执行推理。
使用 XNNPACK 委托在 CPU 上运行:
作为 C++ 应用程序部署
下图显示了创建 C++ 应用程序以运行 LiteRT 模型所涉及的步骤:
创建 C++ 应用程序并运行 LiteRT 模型的工作流
加载 LiteRT 模型
LiteRT 模型是一个 FlatBuffers 文件,包含模型算子、权重和偏置。使用以下 API 加载模型以进行推理:创建 LiteRT 解释器
解释器在选定的委托上配置模型执行,并为前向传播分配内存:使用委托准备模型
以下示例创建 XNNPACK 委托,用于在 Arm® CPU 上运行 LiteRT 模型:准备输入/输出缓冲区
运行推理之前,请对输入数据(例如摄像头帧)进行预处理,使其符合模型期望的格式。常见的预处理步骤包括:- 将输入图像调整为模型期望的分辨率
- 归一化
- 均值减除
运行推理
使用Invoke() API 运行推理。完成后,从解释器中解析输出张量:
使用 Qualcomm IM SDK 部署
gst-ai-classification 示例应用程序使用 Qualcomm IM SDK 插件,在具备硬件加速的 Qualcomm 开发套件上运行 LiteRT 分类模型。
该管道从摄像头接收视频流,执行预处理,在 AI 硬件上运行推理,并显示结果:
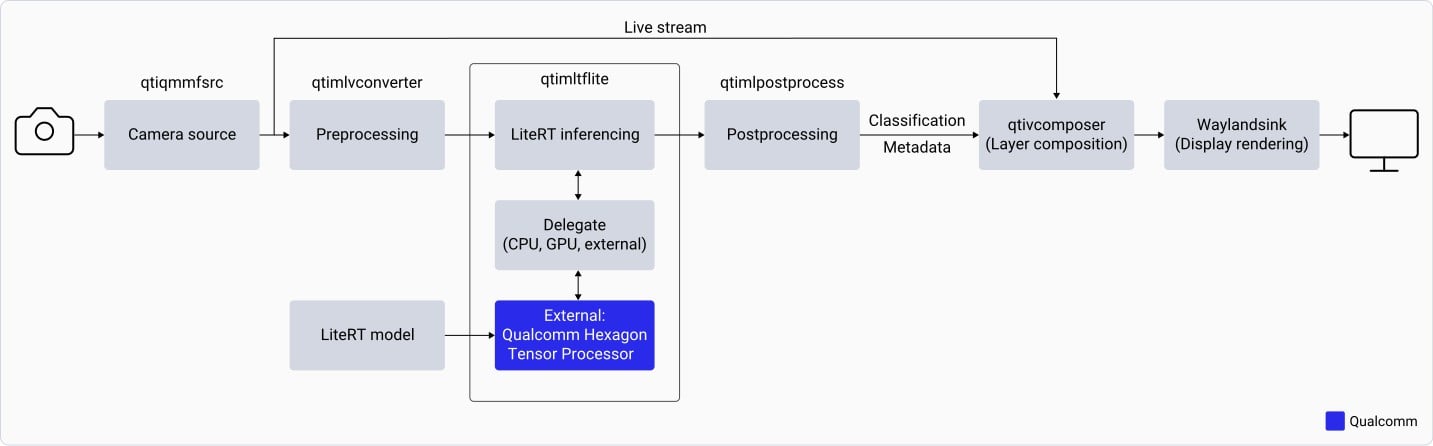
使用 Qualcomm IM SDK 的 LiteRT 模型管道
gst-ai-classification 应用程序会:
- 以指定的分辨率和帧率(例如 1080p、30 fps)打开 IMX577 摄像头。
- 对每个摄像头帧进行预处理——缩小到 224×224,并根据模型要求进行归一化。
- 加载 LiteRT 分类模型,并使用
qtimltflite插件运行推理。 - 从输出张量中提取预测概率最高的标签。
- 将推理结果叠加在原始摄像头帧上,并显示在连接的显示器上。
IQ-2390 不支持 camera 用例。下载模型和标签文件
运行示例应用程序
1
使用 SSH 登录目标设备
2
将视频文件下载到设备
将视频文件下载到设备上的
/etc/media/video.mp4:3
使用示例配置文件运行分类应用程序
/etc/configs/config_classification.json 中的示例配置运行应用程序。要停止应用程序,请按 Ctrl+C。4
(可选)使用自定义配置文件运行分类应用程序
您可以通过 如果指定了 要查看可用的命令行选项,请运行:编辑 运行应用程序:
--config-file 指定路径来使用自定义配置文件:--config-file,应用程序将使用该文件。否则,它将按以下顺序搜索 config_classification.json:要创建用户专属配置,请将示例文件复制到用户配置目录:
config_classification.json 配置文件:应用程序使用
$HOME/Downloads/qimsdk_samples 作为其构件目录。指定相对路径或文件名时,会相对于下方对应的子目录进行解析。绝对路径则按原样使用。