前提条件
- 在主机上设置 QAIRT SDK。 有关详细的安装和配置说明,请参阅设置 Qualcomm AI Runtime SDK。
- 选择要进行性能分析的模型。 您可以使用 QAIRT 工具转换和量化自定义模型,也可以通过 AI Hub 生成量化 模型。有关编译和优化模型的详细指导,请参阅 编译和优化 AI 模型。 以下说明使用来自 AI Hub 的 Inception V3 模型。
- 在设备上启用 Wi-Fi 和 SSH。 设备需要互联网连接才能下载运行示例应用所需的工件。如果已配置 SSH 和 Wi-Fi,请跳过此步骤。 按照设置 SSH 连接在设备上启用 Wi-Fi 和 SSH。
-
确保已在构建过程中在目标设备上安装了以下 QNN 工具。
- qnn-net-run
- qnn-throughput-net-run
- qnn-context-binary-generator
- qnn-profile-viewer
HTP 上的性能分析级别
下表提供了各性能分析级别、其描述及配置:
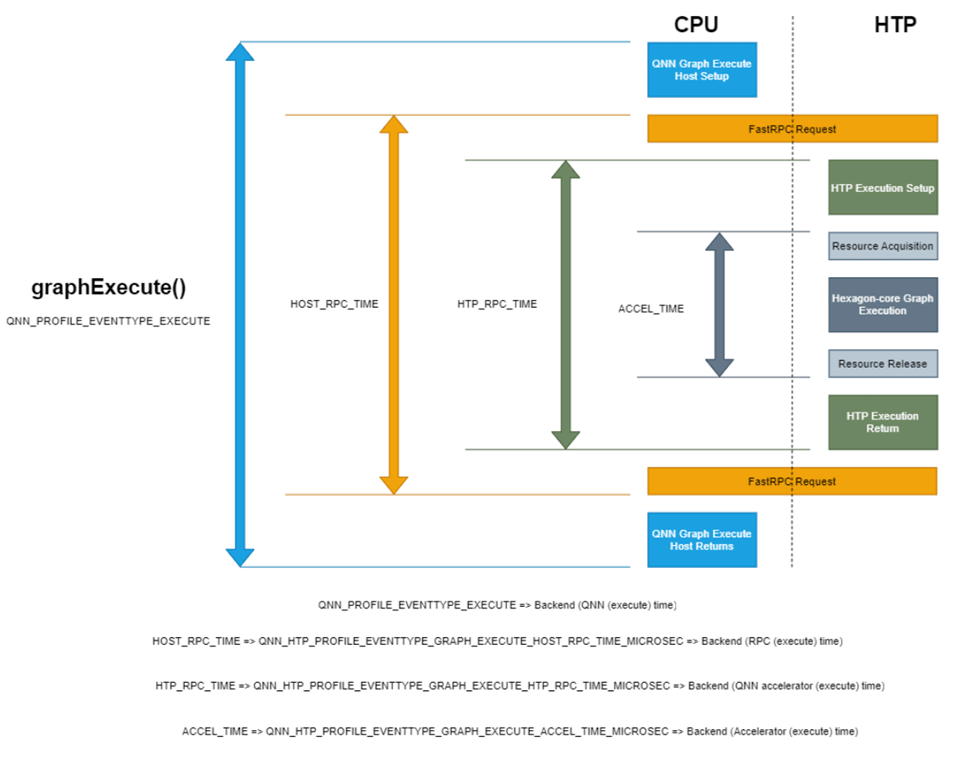
下图展示了 HTP 的主要执行性能分析事件,以及推理期间如何测量这些事件:
使用 qnn-net-run 执行 Lint 性能分析
Lint 性能分析提供主线程上每个操作的详细周期计数以及后台执行信息。以下步骤对 Inception-v3 AI Hub 模型执行 lint 性能分析。请按照这些步骤操作,并将模型替换为您的自定义模型。
-
通过 SSH 登录到目标设备:
出现提示时,输入
oelinux123作为密码。 -
在目标设备上从 AI Hub 下载量化(w8a8)的 inception_v3 dlc 模型
用于性能分析。
-
出于演示目的,您可以使用生成的输入文件对模型进行性能分析。
使用以下针对
inception_v3_quantized.dlc模型定制的 Python 脚本生成这些输入文件。-
将以下脚本以
generate_random_input.py为名保存在/etc/models目录中。此脚本生成 10 个示例输入文件,保存在/tmp/RandomInputsForInceptionV3Profiling/目录中,以及一个包含每个生成样本路径的input_list_profiling.txt文件。 -
在目标设备上运行该脚本:
-
将以下脚本以
-
在目标设备的
/etc/models目录中创建backend_extension_config_file.json和htp_config.json文件, 以使用 HTP 运行时对模型进行性能分析。-
backend_extension_config_file.json -
htp_config.json- 对于 Qualcomm Dragonwing™ RB3 Gen 2,使用
"dsp_arch": "v68" - 对于 Dragonwing IQ-8275,使用
"dsp_arch": "v75" - 对于 Dragonwing IQ-9075,使用
"dsp_arch": "v73"
- 对于 Qualcomm Dragonwing™ RB3 Gen 2,使用
-
-
进入
/etc/models目录,并在目标设备上运行qnn-net-run命令: -
通过指定
--profiling_level=backend启用 lint 性能分析。此步骤可确保应用后端特定配置文件中定义的性能分析级别。 应会在/etc/models/output_htp目录中创建execution_metadata.yaml和qnn-profiling-data_0.log文件。 要查看 qnn-profiling-data_0.log 文件中的日志,请使用 qnn-profile-viewer。
使用 qnn-profile-viewer 查看 lint 性能分析日志
通过将 qnn-profile-viewer 工具与以下插件配合使用,查看在 backend 性能分析级别生成的性能分析输出:- libQnnHtpProfilingReader.so
- libQnnChrometraceProfilingReader.so
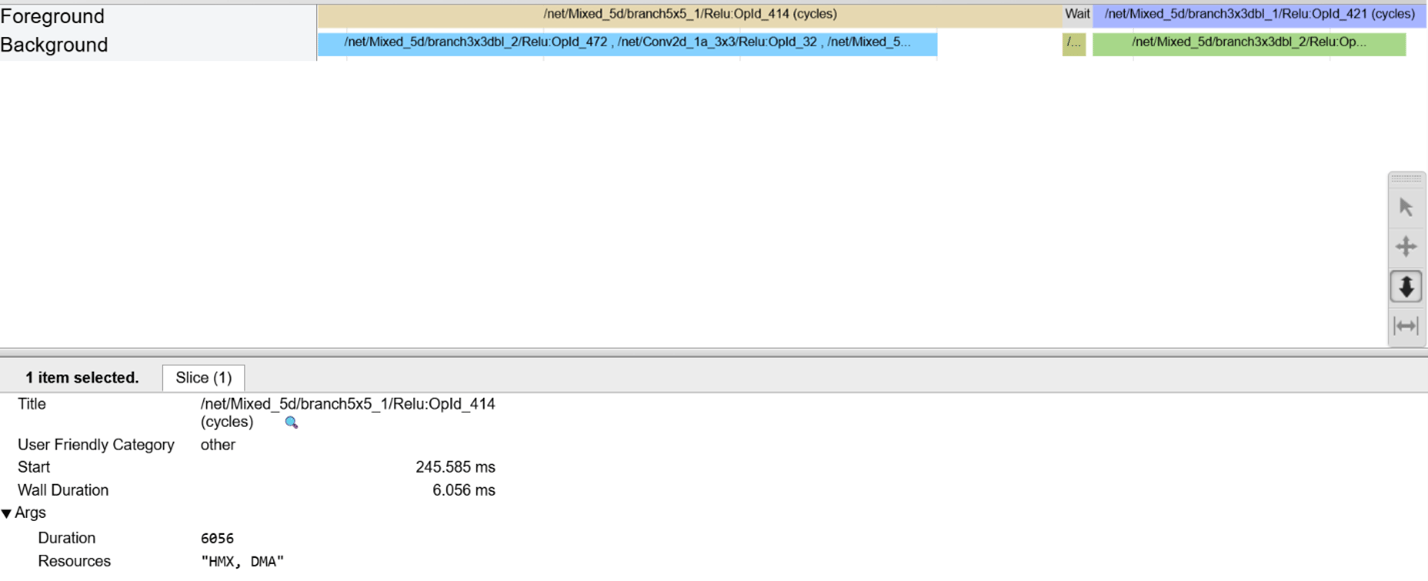
要从推理中检索 linting 信息,请使用 以下是示例输出: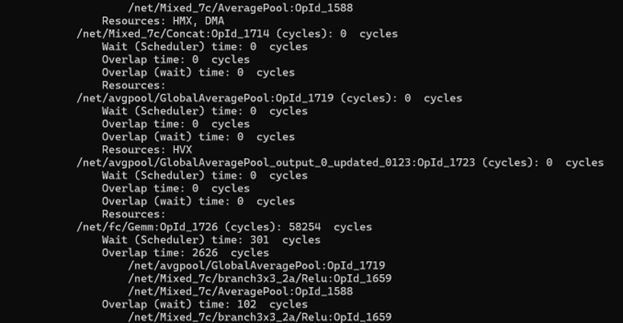
libQnnHtpProfilingReader.so 插件运行 qnn-profile-viewer。此插件提供每次运行的原始输出。- Cycle count:在主线程上执行所花费的时间。
- Wait entry:执行开始前等待所花费的周期数。
- Overlap:主线程执行当前操作时,至少一个后台操作所花费的周期数。
- Overlap (wait):主线程等待期间,至少一个后台操作所花费的周期数。
主线程上的每个操作在执行之前都有一个等待期,该等待期仅在前一个操作结束后才开始。这种延迟可能由调度问题引起,也可能是在等待 HVX 或 DMA 等后台活动完成。
使用 QNN HTP Optrace 执行高级性能分析
使用 QNN optrace 性能分析可了解 QNN HTP 硬件模块的详细内部操作。此功能可帮助您:- 识别可能并行化效果不佳的问题操作。
- 查看操作在整个执行过程中的调度方式。
- 观察各个算子之间的交互。
- 评估 HVX 并行性对每个操作的执行效率。
使用 qnn-throughput-net-run 执行性能分析
使用 qnn-throughput-net-run 在一个或多个 QNN 后端上进行多线程执行。这种性能分析支持多线程执行,并允许您在指定的持续时间内或按设定的迭代次数重复运行模型。在需要并发或重复执行多个模型以进行性能基准测试的场景中,请使用这种性能分析。
-
通过 SSH 登录到目标设备:
出现提示时,输入
oelinux123作为密码。 -
在目标设备上创建一个工作目录。
-
在目标设备上,从 AI Hub 下载量化(w8a8)的 inception_v3 dlc 模型。
-
在目标设备上,在
/etc/models目录中创建backend_extension_config.json和htp_config.json文件。 下一步生成上下文二进制文件时需要这些文件。- backend_extension_config.json
- htp_config.json
- 对于 Qualcomm Dragonwing™ RB3 Gen 2,使用
"dsp_arch": "v68"。 - 对于 Dragonwing IQ-8275,使用
"dsp_arch": "v75"。 - 对于 Dragonwing IQ-9075,使用
"dsp_arch": "v73"。
-
在目标设备上,使用 qnn-context-binary-generator 工具生成上下文二进制文件(.bin 文件)。
qnn-throughput-net-run命令将使用生成的上下文二进制文件。 -
要使用
qnn-throughput-net-run对模型进行性能分析,请在目标设备的/etc/models/目录中创建qtnr_config.json和htp_backend.json文件。htp_backend.json:
qtnr_config.json:
- 对于 Qualcomm Dragonwing™ RB3 Gen 2,使用
"dsp_arch":"v68" - 对于 Dragonwing IQ-8275,使用
"dsp_arch":"v75" - 对于 Dragonwing IQ-9075,使用
"dsp_arch":"v73"
-
要执行性能分析,请在目标设备上运行以下命令:
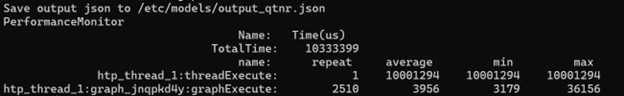
性能分析信息将生成在
/etc/models目录中。