

-
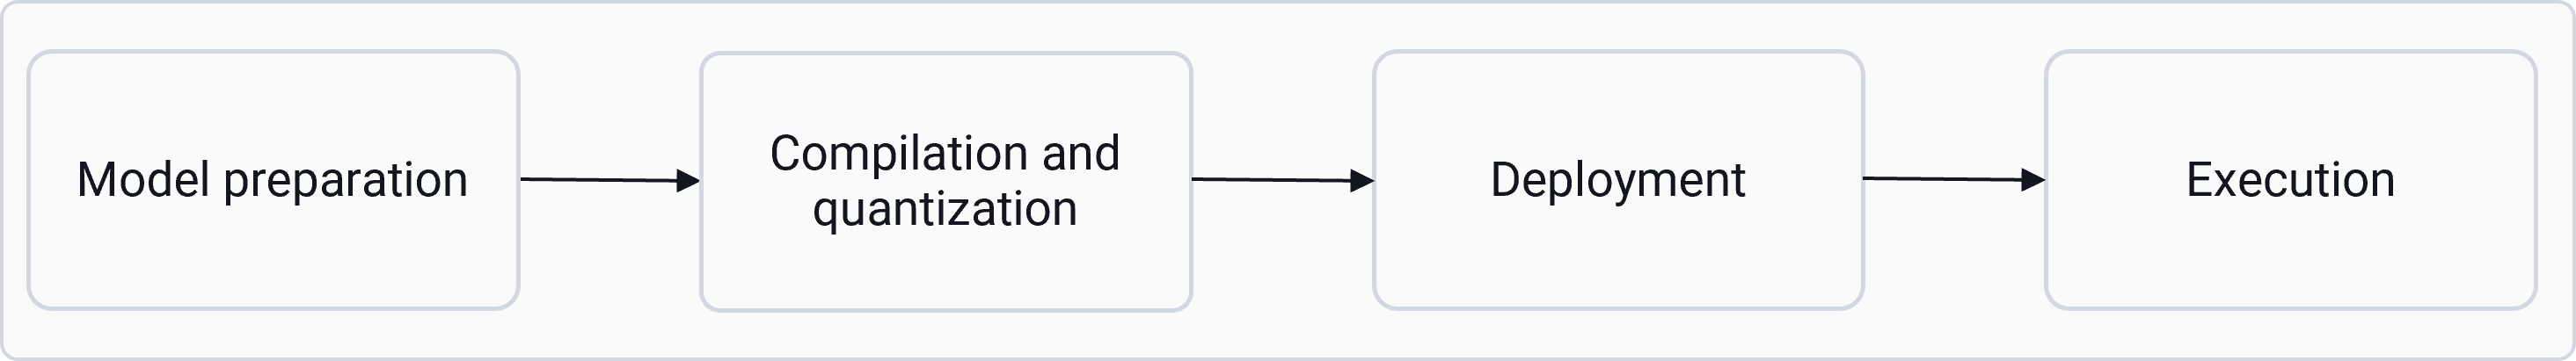
准备模型:
a. 从 Hugging Face 或其他来源获取所需的 LLM(例如 Llama 3.x 系列)。
b. 使用
qai_hub_modelsPython 包导出模型。 此过程会:- 下载模型权重。
- 将其上传到 AI Hub 进行编译。
- 生成拆分为多个部分的 QNN 二进制文件,以便在 NPU 上执行。
- 创建一个可部署的文件夹(
genie_bundle),其中包含所有必需的资产(上下文二进制文件、配置、分词器)。
AI Hub 将模型编译为针对 Qualcomm AI Runtime (QAIRT) SDK 优化的二进制文件:- AI Hub 支持量化(通常内部为 4 位,不过为了兼容性,权重可能以 8 位存储)。
- 导出脚本负责将大型模型拆分为提示处理器和令牌生成器组件。
- 下载模型权重。
-
部署模型:
以下是部署过程的高层步骤。有关详细说明
和命令,请参阅 Run LLMs with Genie。
a. 在目标设备(Android、Windows、Linux)上安装 Qualcomm AI Runtime(QAIRT)SDK。
b. 将编译好的二进制文件和配置文件复制到设备上。
c. 使用 Qualcomm GenerativeAI Inference Extensions (Genie) CLI 工具
(例如
genie-t2t-run)或 Genie dialog API 进行推理。 d. 确保目标设备满足以下要求。本节中的步骤已在使用 Hexagon 架构 V73 的 QCS9100 上验证。- Hexagon 架构:v73 或更新版本
- 所需 RAM:
- 7B 模型需要 16 GB
- 3B 模型约需 12 GB
-
使用与 Qualcomm AI Engine Direct 集成的 Genie API 在设备上运行模型:
- Genie 管理多个二进制文件和执行顺序,以实现最佳的 NPU 利用率。
重要说明
-
AI Hub 优势
- 自动处理模型编译、量化和拆分。
- 提供预先优化的模型和自带模型(BYOM)支持。
-
Genie
- 通过抽象复杂的执行步骤来简化推理。
- 提供用于文本到文本和基于对话的交互的 API。
-
定制
- 导出流程默认使用 4 位量化以提高运行时效率。
- 没有直接将权重存储为 4 位的选项;权重仍为 8 位,但在执行期间以 4 位加载。