> ## Documentation Index
> Fetch the complete documentation index at: https://dragonwingdocs-staging.qualcomm.com/llms.txt
> Use this file to discover all available pages before exploring further.
# 使用 QAIRT SDK 对您的 AI 模型进行性能分析
> 使用 qnn-net-run、qnn-throughput-net-run 和 qnn-profile-viewer 等 QNN 工具,在 Qualcomm Dragonwing IoT 平台上分析 AI 模型性能。
使用 QAIRT SDK 对您的 AI 模型进行性能分析,以测量模型在指定后端上执行的总运行时间并优化性能。性能分析可提供执行期间延迟和硬件利用率的详细洞察。
启用附加的性能分析选项,可查看不同级别的执行时间,例如每个操作或每一层。利用这些性能分析信息识别图执行中的瓶颈和低效之处,从而优化 QNN 运行时并降低模型延迟。
## 前提条件
* 在主机上设置 QAIRT SDK。
有关详细的安装和配置说明,请参阅[设置 Qualcomm AI Runtime SDK](../topic/qairt-setup)。
* 选择要进行性能分析的模型。
您可以使用 QAIRT 工具转换和量化自定义模型,也可以通过 AI Hub 生成量化
模型。有关编译和优化模型的详细指导,请参阅
[编译和优化 AI 模型](../map/compile-and-optimize-model)。
以下说明使用来自 AI Hub 的 Inception V3 模型。
* 在设备上启用 Wi-Fi 和 SSH。
设备需要互联网连接才能下载运行示例应用所需的工件。如果已配置 SSH 和 Wi-Fi,请跳过此步骤。
按照[设置 SSH 连接](https://dragonwingdocs.qualcomm.com/Technologies/Wi-Fi/setup-wi-fi#set-up-uart/ssh)在设备上启用 Wi-Fi 和 SSH。
* 确保已在构建过程中在目标设备上安装了以下 QNN 工具。
* qnn-net-run
* qnn-throughput-net-run
* qnn-context-binary-generator
* qnn-profile-viewer
## HTP 上的性能分析级别
下表提供了各性能分析级别、其描述及配置:
| 性能分析级别 | 描述 | 配置 |
| - | - | - |
| Basic | • 以微秒为单位的模型总执行时间
• 用于延迟测量 | 在 `qnn-net-run` 中使用 `--profiling_level=basic` |
| Detailed | 提供基本信息以及以周期为单位的每操作执行时间。 | 在 `qnn-net-run` 中使用 `--profiling_level=detailed` |
| Lint | • 提供主线程上每个操作的周期计数以及后台执行信息。
• 启用 chrometrace 以进行更深入的分析。 | 在 `qnn-net-run` 中使用 `--profiling_level=backend`,并在 `backend_extension_config.json` 文件内使用 `--profiling_level=linting` |
| Opttrace | • 提供极其详细的操作级 HTP 执行状态。
• 提供 HVX/HMX 利用率和 VTCM 使用情况。
• 用于深入的性能瓶颈分析。 | 在 `qnn-net-run` 中使用 `--profiling_level=detailed` 和 `--profiling_options=optrace` |
下图展示了 HTP 的主要执行性能分析事件,以及推理期间如何测量这些事件:
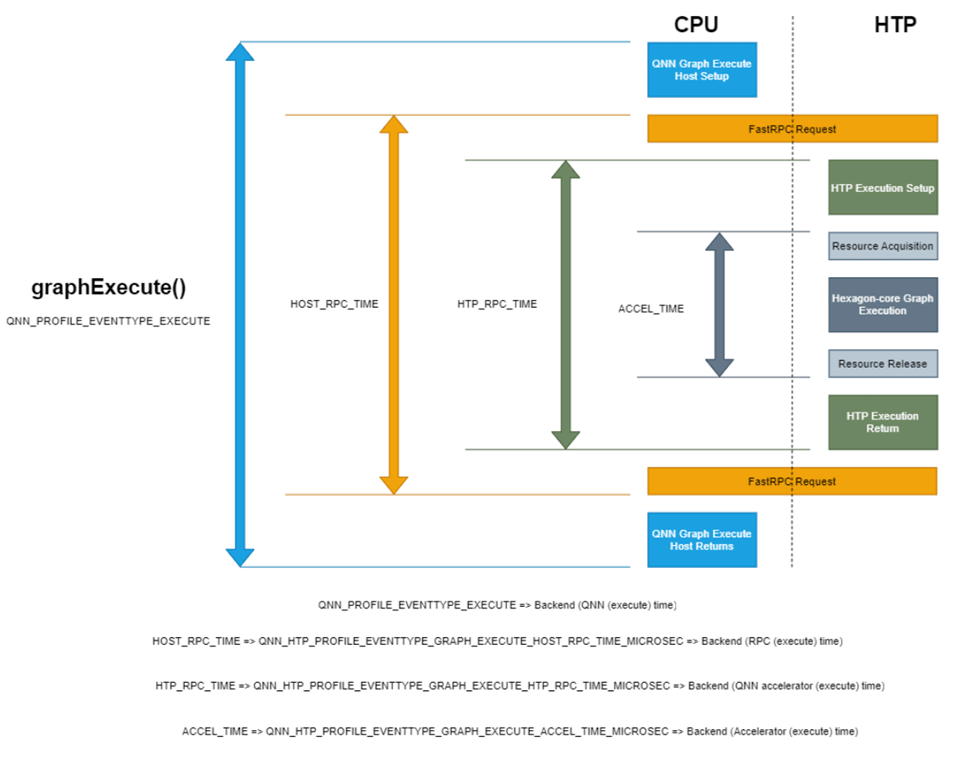 **图:HTP 基本性能分析事件**
## 使用 `qnn-net-run` 执行 Lint 性能分析
Lint 性能分析提供主线程上每个操作的详细周期计数以及后台执行信息。以下步骤对 Inception-v3 AI Hub 模型执行 lint 性能分析。请按照这些步骤操作,并将模型替换为您的自定义模型。
```shell theme={null}
ssh root@
```
出现提示时,输入 `oelinux123` 作为密码。
在目标设备上从 AI Hub 下载量化(w8a8)的 inception\_v3 dlc 模型
用于性能分析。
```shell theme={null}
curl -L https://huggingface.co/qualcomm/Inception-v3/resolve/v0.42.0/Inception-v3_w8a8.dlc -o ${HOME}/models/inception_v3_quantized.dlc
```
出于演示目的,您可以使用生成的输入文件对模型进行性能分析。
使用以下针对 `inception_v3_quantized.dlc` 模型定制的 Python 脚本生成这些输入文件。
创建目录:
```shell theme={null}
mkdir -p ${HOME}/models
```
将以下脚本以 `generate_random_input.py` 为名保存在 `${HOME}/models` 目录中。
```python theme={null}
import os
import numpy as np
input_path_list =[]
BASE_PATH = "/tmp/RandomInputsForInceptionV3Profiling/"
if not os.path.exists(BASE_PATH):
os.mkdir(BASE_PATH)
# generate 10 random inputs and save as raw
NUM_IMAGES = 10
#binary files
for img in range(NUM_IMAGES):
filename = "input_{}.raw".format(img)
randomTensor = np.random.random((1, 224, 224, 3)).astype(np.float32)
filename = os.path.join(BASE_PATH, filename)
randomTensor.tofile(filename)
input_path_list.append(filename)
#for saving as input_list text
with open("input_list_profiling.txt", "w") as f:
for path in input_path_list:
f.write(path)
f.write("\n")
```
此脚本生成 10 个示例输入文件,保存在 `/tmp/RandomInputsForInceptionV3Profiling/`
目录中,以及一个包含每个生成样本路径的 `input_list_profiling.txt` 文件。
在目标设备上运行该脚本:
```shell theme={null}
python3 ${HOME}/models/generate_random_input.py
```
在目标设备的 `${HOME}/models` 目录中创建 `backend_extension_config_file.json` 和 `htp_config.json` 文件,
以使用 HTP 运行时对模型进行性能分析。
* `backend_extension_config_file.json`
```json theme={null}
{
"backend_extensions": {
"shared_library_path" : "libQnnHtpNetRunExtensions.so",
"config_file_path" : "./htp_config.json"
}
}
```
* `htp_config.json`
```json theme={null}
{
"graphs": [
{
"vtcm_mb": 2,
"fp16_relaxed_precision": 0,
"graph_names": [
"graph_name_1"
],
"O": 3.0
}
],
"devices": [
{
"dsp_arch": "v68",
"profiling_level": "linting",
"cores": [
{
"perf_profile": "burst"
}
]
}
]
}
```
* 对于 Qualcomm Dragonwing™ RB3 Gen 2,使用 `"dsp_arch": "v68"`
* 对于 Dragonwing IQ-8275,使用 `"dsp_arch": "v75"`
* 对于 Dragonwing IQ-9075,使用 `"dsp_arch": "v73"`
* 对于 Dragonwing IQX-7181,使用 `"dsp_arch": "v73"`
* 对于 Dragonwing IQX-5121,使用 `"dsp_arch": "v73"`
进入 `${HOME}/models` 目录,并在目标设备上运行 `qnn-net-run` 命令:
```shell theme={null}
qnn-net-run --model libQnnModelDlc.so \
--backend libQnnHtp.so \
--input_list input_list_profiling.txt \
--config_file backend_extension_config_file.json \
--output_dir output_htp \
--profiling_level backend \
--dlc_path ${HOME}/models/inception_v3_quantized.dlc
```
通过指定 `--profiling_level=backend` 启用 lint 性能分析。此步骤可确保应用后端特定配置文件中定义的性能分析级别。
应会在 `${HOME}/models/output_htp` 目录中创建 `execution_metadata.yaml` 和 `qnn-profiling-data_0.log` 文件。
要查看 qnn-profiling-data\_0.log 文件中的日志,请使用 qnn-profile-viewer。
 ## 使用 qnn-profile-viewer 查看 lint 性能分析日志
通过将 qnn-profile-viewer 工具与以下插件配合使用,查看在 backend 性能分析级别生成的性能分析输出:
要从推理中检索 linting 信息,请使用 `libQnnHtpProfilingReader.so` 插件运行 qnn-profile-viewer。此插件提供每次运行的原始输出。
```shell theme={null}
qnn-profile-viewer --reader libQnnHtpProfilingReader.so --input_log ${HOME}/models/output_htp/qnn-profiling-data_0.log --output ${HOME}/models/output_htp/profile_htp.csv
```
以下是示例输出:
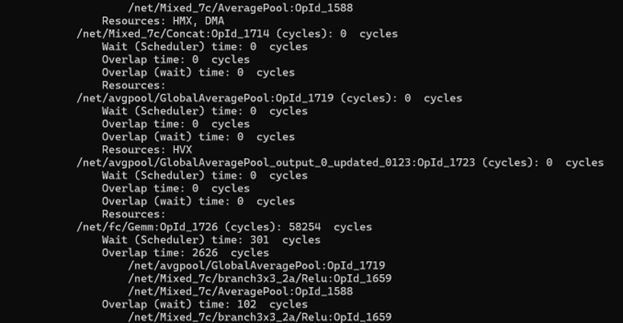 **图:使用 libQnnHtpProfilingReader.so 进行 Lint 性能分析的示例输出**
在 linting 性能分析报告中,每个操作都有:
* **Cycle count**:在主线程上执行所花费的时间。
* **Wait entry**:执行开始前等待所花费的周期数。
* **Overlap**:主线程执行当前操作时,至少一个后台操作所花费的周期数。
* **Overlap (wait)**:主线程等待期间,至少一个后台操作所花费的周期数。
主线程上的每个操作在执行之前都有一个等待期,该等待期仅在前一个操作结束后才开始。这种延迟可能由调度问题引起,也可能是在等待 HVX 或 DMA 等后台活动完成。
`libQnnChrometraceProfilingReader.so` 插件提供所有运行的平均输出。
此外,如果使用 `--output` 选项指定了输出文件,则会生成一个
包含 chrometrace 格式性能分析数据的文件。
```
qnn-profile-viewer --reader libQnnChrometraceProfilingReader.so --input_log ${HOME}/models/output_htp/qnn-profiling-data_0.log --output ${HOME}/models/output_htp/chromeTrace.json
```
下图显示了示例输出:
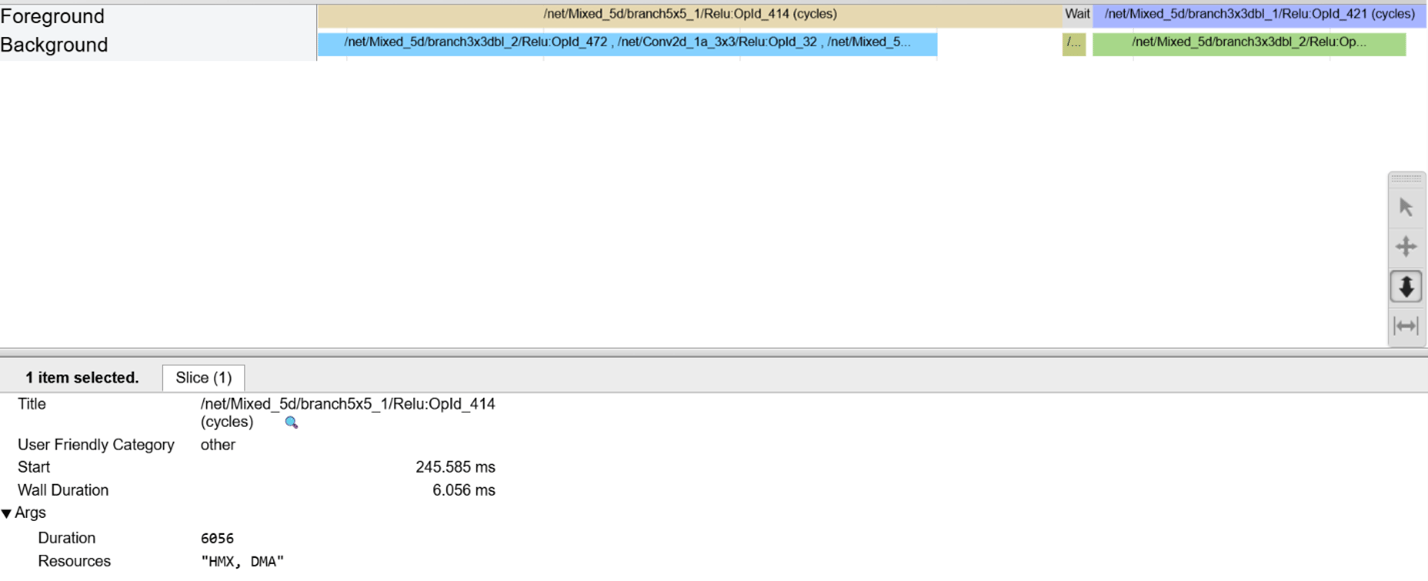 **图:使用 libQnnChrometraceProfilingReader.so 进行 Lint 性能分析的示例输出**
要查看 chrome trace,请使用 Google Chrome。
## 使用 QNN HTP Optrace 执行高级性能分析
使用 QNN optrace 性能分析可了解 QNN HTP 硬件模块的详细内部操作。此功能可帮助您:
* 识别可能并行化效果不佳的问题操作。
* 查看操作在整个执行过程中的调度方式。
* 观察各个算子之间的交互。
* 评估 HVX 并行性对每个操作的执行效率。
要进一步了解 QNN HTP optrace 性能分析,请参阅 [QNN HTP Optrace Profiling](https://docs.qualcomm.com/nav/home/htp_backend.html?product=1601111740009302#qnn-htp-optrace-profiling)。
## 使用 `qnn-throughput-net-run` 执行性能分析
使用 qnn-throughput-net-run 在一个或多个 QNN 后端上进行多线程执行。这种性能分析支持多线程执行,并允许您在指定的持续时间内或按设定的迭代次数重复运行模型。在需要并发或重复执行多个模型以进行性能基准测试的场景中,请使用这种性能分析。
```shell theme={null}
ssh root@
```
出现提示时,输入 `oelinux123` 作为密码。
在目标设备上创建一个工作目录。
```shell theme={null}
mkdir -p ${HOME}/models
```
在目标设备上,从 AI Hub 下载量化(w8a8)的 inception\_v3 dlc 模型。
```shell theme={null}
curl -L https://huggingface.co/qualcomm/Inception-v3/resolve/v0.42.0/Inception-v3_w8a8.dlc -o ${HOME}/models/inception_v3_quantized.dlc
```
在目标设备上,在 `${HOME}/models` 目录中创建 `backend_extension_config.json` 和 `htp_config.json` 文件。
下一步生成上下文二进制文件时需要这些文件。
* **backend\_extension\_config.json**
```json theme={null}
{
"backend_extensions": {
"shared_library_path": "libQnnHtpNetRunExtensions.so",
"config_file_path": "./htp_config.json"
}
}
```
* **htp\_config.json**
```json theme={null}
{
"graphs": [
{
"vtcm_mb": 2,
"fp16_relaxed_precision": 0,
"graph_names": [
"graph_name_2"
],
"O": 3.0
}
],
"devices": [
{
"dsp_arch": "v68",
"profiling_level": "linting",
"cores": [
{
"perf_profile": "burst"
}
]
}
]
}
```
* 对于 Qualcomm Dragonwing™ RB3 Gen 2,使用 `"dsp_arch": "v68"`。
* 对于 Dragonwing IQ-8275,使用 `"dsp_arch": "v75"`。
* 对于 Dragonwing IQ-9075,使用 `"dsp_arch": "v73"`。
在目标设备上,使用 qnn-context-binary-generator 工具生成上下文二进制文件(.bin 文件)。
```shell theme={null}
qnn-context-binary-generator --log_level=info --backend libQnnHtp.so --model libQnnModelDlc.so --config_file ${HOME}/models/backend_extension_config.json --output_dir context_bin_dir --dlc_path ${HOME}/models/inception_v3_quantized.dlc --binary_file inception_v3
```
`qnn-throughput-net-run` 命令将使用生成的上下文二进制文件。
要使用 `qnn-throughput-net-run` 对模型进行性能分析,请在目标设备的 `${HOME}/models/` 目录中创建 `qtnr_config.json` 和
`htp_backend.json` 文件。
* `htp_backend.json`:
```json theme={null}
{
"devices": [
{
"dsp_arch": "v68",
"device_id" : 0
}
]
}
```
* `qtnr_config.json`:
```json theme={null}
{
"backends": [
{
"backendName": "htp_backend",
"backendPath": "libQnnHtp.so",
"profilingLevel": "BASIC",
"backendExtensions": "libQnnHtpNetRunExtensions.so",
"perfProfile": "burst"
}
],
"models": [
{
"modelName": "inception_v3",
"modelPath": "/root/models/context_bin_dir/inception_v3.bin",
"loadFromCachedBinary": true,
"outputPath": "output_original"
}
],
"contexts": [
{
"contextName": "htp_context_1",
"priority": "HIGH"
}
],
"testCase": {
"iteration": 1,
"logLevel": "info",
"threads": [
{
"threadName": "htp_thread_1",
"backend": "htp_backend",
"context": "htp_context_1",
"model": "inception_v3",
"interval": 0,
"loopUnit": "second",
"loop": 10,
"backendConfig": "htp_backend.json"
}
]
}
}
```
* 对于 Qualcomm Dragonwing™ RB3 Gen 2,使用 `"dsp_arch"`: `"v68"`
* 对于 Dragonwing IQ-8275,使用 `"dsp_arch"`: `"v75"`
* 对于 Dragonwing IQ-9075,使用 `"dsp_arch"`: `"v73"`
要执行性能分析,请在目标设备上运行以下命令:
```shell theme={null}
cd ${HOME}/models
```
```shell theme={null}
qnn-throughput-net-run --config ${HOME}/models/qtnr_config.json --output ${HOME}/models/output_qtnr.json
```
性能分析信息将生成在 `${HOME}/models` 目录中。
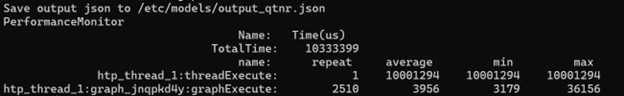 **图:qnn-throughput-net-run 性能分析的示例输出**