

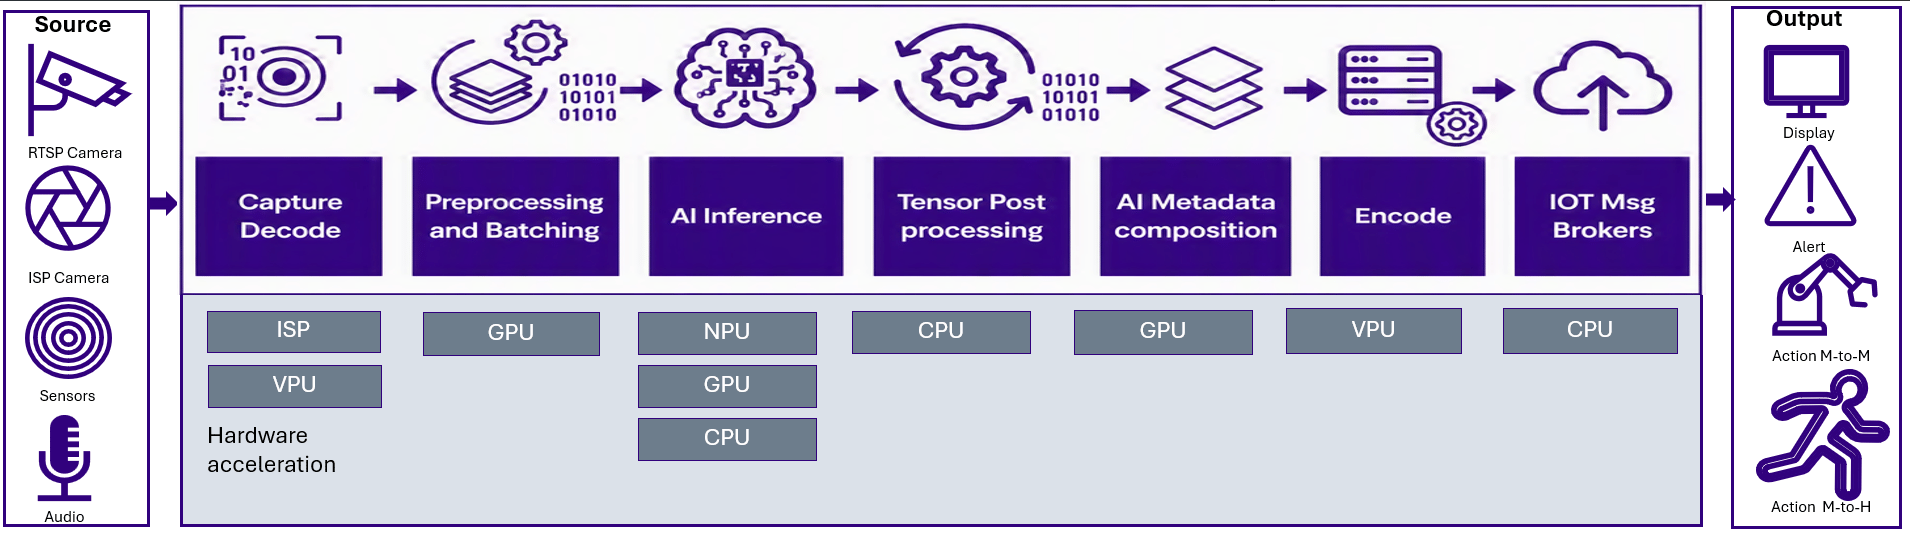
QIM SDK 将每个管线阶段映射到最合适的硬件模块
本页提供 AI 开发者工作流的工作流级概述。有关完整的 SDK 参考资料,包括安装、插件目录、App Builder API、示例管线和参考应用程序,请参阅 QIM SDK 文档。
为什么使用 QIM SDK?
QIM SDK 可减少在 Qualcomm 平台上构建经过优化的 AI 和多媒体应用程序所需的工作量。它具有以下优势:统一的多媒体和 AI 管线
在一个基于 GStreamer 的工作流中运行采集、预处理、推理、后处理、渲染、编码和流式传输,而无需将多个独立的应用程序拼接在一起。
默认硬件加速
使用 Qualcomm CPU、GPU、NPU/HTP、摄像头 ISP、视频、显示和 DSP 引擎,使每个管线阶段都在最适合该任务的硬件模块上运行。
零拷贝缓冲区流转
以 DMA-buf 句柄的形式在兼容的管线阶段之间传递帧,以减少 CPU 拷贝、内存带宽占用和延迟。
GPU 加速的前处理和后处理
在 Adreno GPU 上运行缩放、颜色转换、张量布局转换和叠加渲染,使 CPU 可用于应用程序逻辑。
灵活的 AI 运行时支持
根据模型格式、性能目标和部署要求,选择 LiteRT/TFLite、ONNX、Qualcomm AI Engine Direct 或 SNPE 运行时路径。
Qualcomm AI Hub 集成
从 Qualcomm AI Hub 中预训练并经过优化的模型开始,并将其集成到 QIM SDK 参考管线中。
零拷贝如何提升性能
传统媒体管线通常会在各阶段之间拷贝帧。这些拷贝会增加 CPU 使用率、内存流量和端到端延迟。当路径中的所有插件都支持零拷贝操作时,QIM SDK 会以共享 DMA-buf 句柄的形式传递帧,从而避免不必要的拷贝。- 摄像头 ISP、GPU、NPU/HTP、视频和显示模块可以对共享缓冲区进行操作,而无需反复进行 CPU 内存拷贝。
- GStreamer 分配协商机制使兼容的插件能够就 DMA-buf 的分配和导入行为达成一致。
- 其结果是内存带宽更低、CPU 负载更小、延迟得到改善,这对于高分辨率、多路流和实时工作负载尤为明显。
只有当路径中的每个插件都支持零拷贝时,零拷贝才会生效。如果您添加了需要 CPU 映射缓冲区的元素,管线将在该位置回退为拷贝。在向加速管线中添加自定义或第三方元素时,请考虑这一点。
GPU 加速的前处理和后处理
当 NPU/HTP 能够不间断地接收格式正确的张量时,AI 推理性能最佳。QIM SDK 使用 Adreno GPU 执行数据整形和叠加工作,从而降低 CPU 负载并帮助保持推理路径的高效。- 前处理:
qtimlvconverter在 GPU 上执行颜色空间转换、缩放和张量布局变换,以生成模型所需的输入张量。 - 后处理:
qtimlpostprocess将模型输出张量解码为结构化的 ML 元数据,例如边界框、标签和掩码。随后qtivoverlay使用 GPU 将这些元数据渲染到帧上。
后续步骤
使用 QIM SDK 进行应用程序开发
继续了解开发工作流,查看重要的 QIM SDK 组件、应用程序开发工作流,以及后处理模块和支持的用例。
相关信息
- 运行推理 — 将 QIM SDK 与其他运行时和集成路径进行比较。
- 准备您的模型 — 在集成模型之前对其进行转换、量化或微调。
- 使用 QAIRT C++ API 开发 AI 应用程序 — 当您的应用程序不是多媒体管线时,使用更底层的 API 路径。
- QIM SDK 文档 — 完整的 SDK 参考。