> ## Documentation Index
> Fetch the complete documentation index at: https://dragonwingdocs-staging.qualcomm.com/llms.txt
> Use this file to discover all available pages before exploring further.
# 概述
> 在 Qualcomm 平台上构建 AI 应用程序的工具、运行时和框架概述,并提供选择模型准备和运行方式的引导路径。
本指南介绍如何使用 Qualcomm Dragonwing 物联网平台支持的工具、运行时和框架进行 AI 应用程序开发。它面向希望训练或微调模型、为部署做准备并在 Qualcomm 硬件上构建 AI 应用程序的开发者。
本指南中的大多数决策都归结为三个问题:
* **您要构建什么?** 经典 ML/视觉、生成式 AI (LLM/VLM) 或语音 AI — 每一类都有各自的工具和快速入门路径。
* **您将如何准备模型?** 针对目标硬件对其进行转换、量化、编译或微调。
* **您将如何运行推理?** 在设备上执行模型的运行时、容器或集成路径。
您可以引入来自 ONNX、PyTorch、TensorFlow 或 LiteRT 的预训练模型,或者从 Qualcomm 提供的可直接运行的 LLM、VLM、ASR 和 TTS 模型开始,并在 Qualcomm Kryo™ CPU、Adreno™ GPU 和 Hexagon™ NPU (HTP) 上高效运行它们。
我们假设设备设置已经完成。如果尚未完成,请先按照"设备设置和软件更新"部分中的说明进行操作,然后再继续。
## 选择您的旅程
使用下面的流程图找到适合您应用程序的路径。它会引导您确认是否已有模型、您要构建什么、如何**准备**模型 (紫色) 以及如何**运行推理** (蓝色),然后链接到正确的 QLI 指南。每个高亮框都可以点击。
```mermaid theme={null}
%%{init: {"flowchart": {"rankSpacing": 110, "nodeSpacing": 65}} }%%
flowchart TD
Q1{"您是否已有
训练好的模型?"}
Q1 -->|"没有,先展示
它能做什么"| RunPrebuilt["运行预构建的 AI 模型和应用
Qdemo UI · 预构建示例 · IM SDK"]
Q1 -->|"我想用自己的数据
微调模型"| EI["Edge Impulse"]
Q1 -->|"有 / 自带模型
ONNX · PyTorch · TF · LiteRT"| TypeQ{"您要构建什么?"}
TypeQ -->|"经典 ML / 视觉"| Prep{"准备模型"}
TypeQ -->|"生成式 AI
LLM · VLM"| GenAI["设备端 GenAI 工作流
Genie"]
Prep -->|"现成模型,或在云端
自带模型 (BYOM)"| AIHub["Qualcomm AI Hub
现成模型 · BYOM
(在云端优化)"]
Prep -->|"在本地转换 + 量化
自己的模型"| QAIRT["Qualcomm AI Runtime SDK
(QAIRT)"]
Prep -->|"恢复量化
精度"| AIMET["AIMET (PTQ / QAT)"]
AIHub --> Runtime{"运行推理"}
QAIRT --> Runtime
AIMET --> Runtime
Runtime -->|"Python / 快速运行 .tflite"| LiteRT["LiteRT / TFLite
AI Engine Direct delegate"]
Runtime -->|"ONNX 模型"| ONNXRun["ONNX Runtime
AI Engine Direct"]
Runtime -->|"C++ / 底层控制
SNPE 或 QNN"| QAIRTcpp["QAIRT SDK C++ API"]
Runtime -->|"摄像头 / 视频 +
AI 管线"| IMSDK["Qualcomm IM SDK
GStreamer · 零拷贝 · GPU 前/后处理"]
click RunPrebuilt "../map/run-prebuilt-models-and-apps"
click EI "../topic/edge-impulse"
click GenAI "../map/run-on-device-genai"
click VoiceContainer "../map/run-on-device-voice-ai"
click Whisper "../topic/whisper"
click AIHub "../topic/ai-hub"
click QAIRT "../topic/qairt"
click AIMET "../topic/aimet"
click LiteRT "../topic/litert-overview"
click ONNXRun "../topic/onnxruntime"
click QAIRTcpp "../topic/develop-your-own-application-qairt-cpp"
click IMSDK "../topic/develop-your-own-application-im-sdk"
classDef prep fill:#31017D,stroke:#31017D,color:#fff;
classDef run fill:#3253DC,stroke:#3253DC,color:#fff;
classDef genai fill:#B45309,stroke:#B45309,color:#fff;
class AIHub,QAIRT,AIMET,EI prep;
class RunPrebuilt,LiteRT,ONNXRun,QAIRTcpp,IMSDK run;
class GenAI genai;
```
设备端生成式 AI 的可用性取决于您的 Qualcomm Linux 版本。有关当前支持状态,请参阅 [GenAI 工作流](../map/run-on-device-genai)页面。
## AI 架构
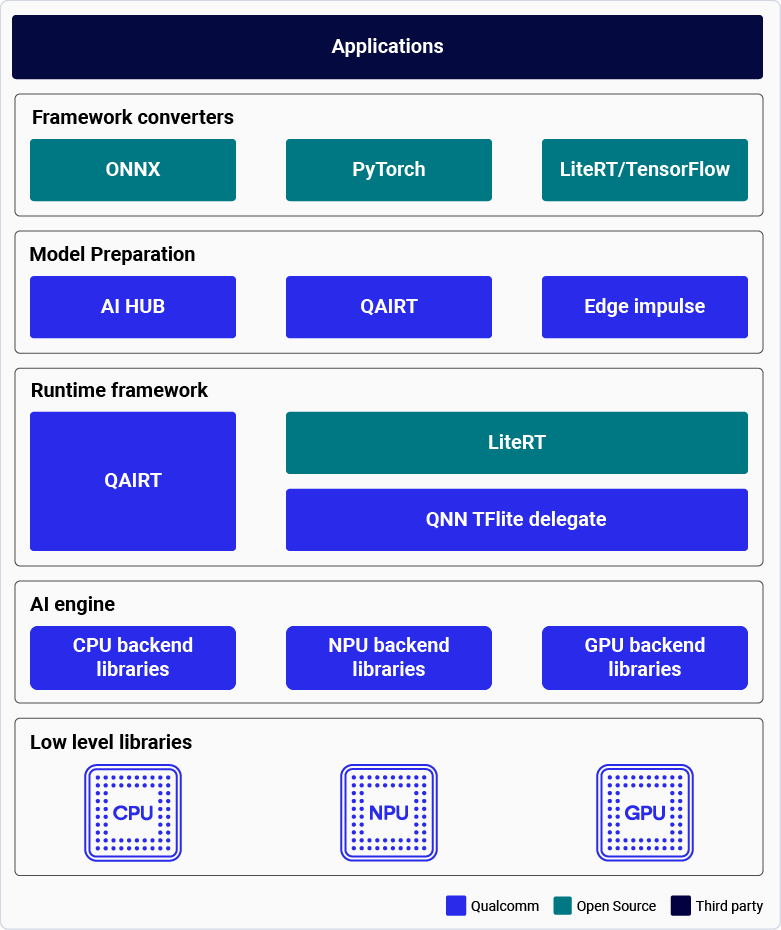
下图展示了 Qualcomm 平台上的 AI 应用程序开发架构。
 ## 应用程序开发和执行流程汇总
| 流程 | 用途 |
| - | - |
| [Edge Impulse](../topic/edge-impulse) | 使用音频、图像和其他传感器数据构建和训练 AI 模型,或引入多种格式的自有模型。 |
| [Qualcomm AI Hub](../topic/ai-hub) | 下载预优化模型,或自带模型 (BYOM),并在几分钟内于托管的 Qualcomm 平台设备上完成优化、验证和部署。 |
| [Qualcomm AI Runtime SDK (QAIRT)](../topic/qairt) | 在本地转换、量化和编译来自 TensorFlow、PyTorch、LiteRT 或 ONNX 的模型,以便部署到 NPU。 |
| [AIMET (PTQ / QAT)](../topic/aimet) | 使用训练后量化或量化感知训练恢复量化过程中损失的精度。 |
| [LiteRT / TFLite](../topic/litert-overview) | 使用 AI Engine Direct delegate 在 NPU 上运行 `.tflite` 模型 (Python 或 C++)。适用于来自 AI Hub、QAIRT 或 Edge Impulse 的模型。 |
| [ONNX Runtime](../topic/onnxruntime) | 使用搭配 AI Engine Direct 的 ONNX Runtime 在 NPU 上运行 ONNX 模型。 |
| [Genie](../topic/use-genai-model-with-genie) | 编排设备端生成式 AI (LLM/VLM) 工作流,并在 NPU 上运行文本、图像和音频推理。 |
| [GenieX](../topic/geniex) | 只需几行代码,即可在 Hexagon NPU、Adreno GPU 或 CPU 上本地运行前沿语言模型和视觉语言模型。 |
| [使用 SNPE 或 QNN 运行模型](../topic/run-models) | 使用 QAIRT SDK C/C++ API 在 CPU、GPU 或 HTP 上运行转换后的 `.dlc` 或 `.so` 文件。 |
| [Qualcomm IM SDK](../topic/develop-your-own-application-im-sdk) | 使用 GStreamer、零拷贝缓冲区和 GPU 前/后处理构建高性能摄像头和视频 AI 管线。 |
## 准备您的模型
在模型能够在 Qualcomm 硬件上高效运行之前,需要将其转换为可执行格式,并且对于 Hexagon NPU (HTP),还需将其量化为支持的精度。(LiteRT 模型是个例外: 它们可通过 AI Engine Direct delegate 直接运行。) 请选择与您的起点相匹配的准备工具。
| 工具 | 用途 | 输出 |
| - | - | - |
| [Qualcomm AI Hub](../topic/ai-hub) | 下载预优化模型,或**自带模型 (BYOM)**,由 QAIRT 针对您的目标芯片组**在云端进行编译、转换和量化**,无需本地工具链。 | 可直接运行的 LiteRT 或 Qualcomm AI Engine Direct 模型 |
| [Qualcomm AI Runtime SDK (QAIRT)](../topic/qairt) | AI Hub BYOM 的**本地**替代方案: 自行转换、量化和编译来自 TensorFlow、PyTorch、LiteRT 或 ONNX 的模型。集成了 AI Engine Direct 和 Neural Processing SDK。 | 量化模型 / 编译后的上下文二进制文件 |
| [Qualcomm AI Model Efficiency Toolkit](../topic/aimet) | 使用训练后量化 (PTQ) 和量化感知训练 (QAT) 恢复量化过程中损失的精度。 | 精度更高的量化模型 |
| [Edge Impulse](../topic/edge-impulse) | 基于您自己的音频、图像和传感器数据构建、训练或微调模型。 | 您所选格式的已训练模型 |
## 运行推理
模型准备好之后,选择如何在设备上执行它。您选择的运行时取决于您使用的语言、模型格式,以及您是否要构建完整的摄像头/视频管线。
| 运行时 / 集成 | 最适用于 |
| - | - |
| [LiteRT](../topic/litert-overview) | 使用 Qualcomm AI Engine Direct delegate,通过 Python 或 C++ 实现高性能设备端推理。 |
| [QAIRT SDK C++ API](../topic/develop-your-own-application-qairt-cpp) | 对模型执行和推理后端进行底层 C++ 控制。 |
| [Qualcomm Intelligent Multimedia SDK (IM SDK)](../topic/develop-your-own-application-im-sdk) | 高性能摄像头、视频和视觉管线,融合采集、预处理、推理和渲染,支持零拷贝缓冲区和 GPU 前/后处理。 |
| [Qualcomm® GenAI Inference Engine (Genie)](https://docs.qualcomm.com/doc/80-63442-10/topic/index_Genie.html) | 运行和编排设备端生成式 AI (LLM、多模态) 工作流。 |
| [使用 Geniex 运行 LLM/VLM](../topic/geniex) | 通过 GenieX CLI 在 NPU 上运行 LLM/VLM 文本、图像和音频推理的最快方式。 |
正在构建机器人应用程序?[Qualcomm® Intelligent Robotics (QIR) SDK](https://www.thundercomm.com/rubik-pi-3/en/docs/rubik-pi-3-user-manual/1.0.0-u/Application%20Development%20and%20Execution%20Guide/Robotics-Sample-Applications/Robotics%20Sample%20Applications/) 在这些运行时之上添加了基于 ROS 的模块和硬件加速节点。
## AI 硬件
Qualcomm 平台包含以下用于 AI 推理的硬件加速器:
* **Qualcomm Kryo™ CPU** — 具有一流能效的高性能 CPU。
* **Qualcomm Adreno™ GPU**: 为 AI 工作负载提供均衡的功耗和性能,可通过 OpenCL 内核加速。也用于模型**前处理和后处理** (例如,IM SDK 在 GPU 上运行缩放、颜色转换和叠加)。
* **Qualcomm Hexagon™ Tensor Processor (HTP)**: 也称为 NPU/DSP/HMX。针对低功耗、高性能 AI **推理**进行了优化。为获得最佳性能,请将预训练模型量化为支持的精度。